Краткое руководство по регистру букв
Регистр букв — это способ, которым письменные языки различают более крупные прописные и меньшие строчные буквы. В системах письма, имеющих оба варианта, каждой прописной соответствует строчная, разделяющая то же имя, звучание и место в алфавите. Ниже — краткий обзор преобразований, которые выполняет этот инструмент, и того, когда их применять.
Регистр и текст
ВЕРХНИЙ РЕГИСТР
Каждая буква показана в заглавной форме. Подходит для коротких меток, предупреждений и аббревиатур; избегайте для длиннее нескольких слов — читать сложнее и кажется криком.
нижний регистр
Каждая буква показана в строчной форме. В современных текстах это значение по умолчанию для основного текста — легко сканировать и не отвлекает на странице.
Регистр предложения
В верхнем регистре только первая буква каждого предложения, плюс имена собственные и всё, что требует английская грамматика. Естественный выбор для абзацев, интерфейсных текстов и разговорного стиля.
Регистр заголовка
Главные слова — существительные, глаголы, прилагательные — с прописной, короткие артикли, предлоги и союзы остаются в нижнем регистре. Классический стиль заголовков.
С заглавной
Первая буква каждого слова — прописная, остальные — строчные. В отличие от стиля «Регистр заголовка», исключений для коротких слов нет. Часто используется для имён, брендов и коротких меток.
чЕрЕдОвАнИе
Начинается со строчной и далее меняется посимвольно, без учёта исходного регистра. Чаще всего применяется в соцсетях как стилистический приём.
оБРАТНЫЙ рЕГИСТР
Меняет регистр каждой буквы на противоположный. Удобно для быстрых визуальных эффектов и для проверки необычных шаблонов регистра в исходной строке.
Перевернуть
Переворачивает порядок всех символов текста. Полезно для быстрой обфускации, проверки палиндромов и игривой типографики.
Очистить пробелы
Сворачивает подряд идущие пробелы в один, обрезает пробелы по краям каждой строки и удаляет пустые строки. Идеально для текста, скопированного из Word или PDF.
Убрать дубли
Удаляет повторяющиеся строки, оставляя первое вхождение. Порядок остальных строк сохраняется.
Сортировать строки
Сортирует строки по алфавиту с учётом локали. Удобно для списков, столбцов CSV и наборов ключей JSON.
Убрать Markdown
Удаляет синтаксис Markdown — заголовки, выделения, блоки кода, ссылки, изображения, списки — и возвращает обычный текст.
Разработчик
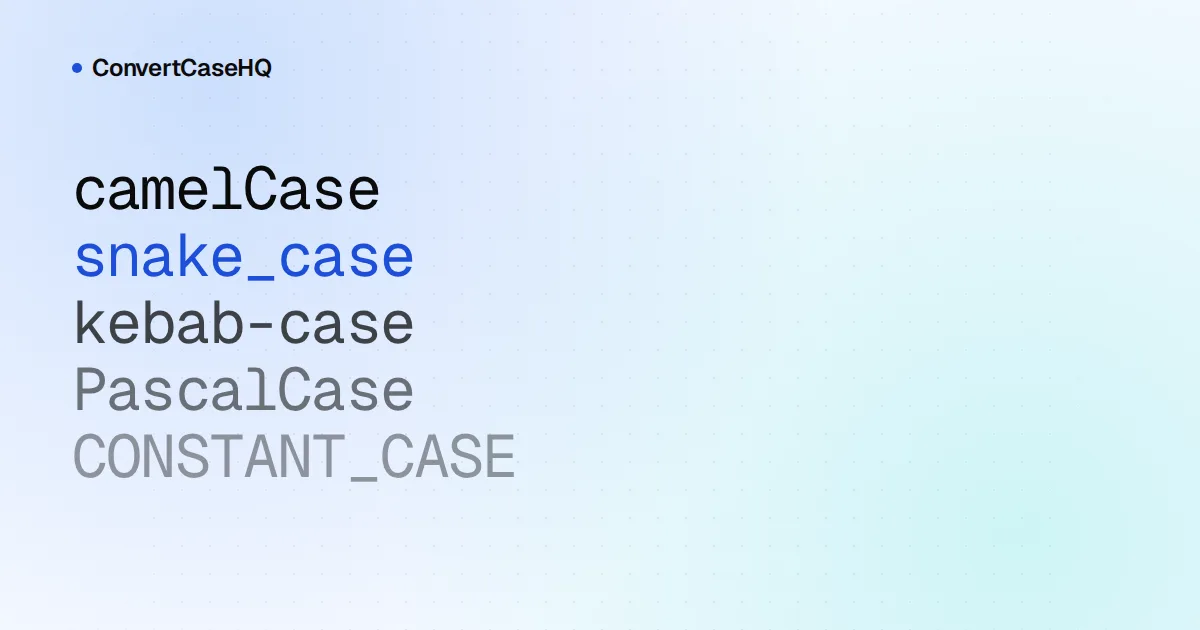
camelCase
Стиль для разработчиков: первое слово со строчной буквы, последующие — с заглавной, всё слитно. По умолчанию для переменных и функций в JavaScript, Java и Swift.
PascalCase
Каждое слово (включая первое) — с заглавной буквы и слитно. Используется для имён типов: классов, интерфейсов и React-компонентов.
snake_case
Слова в нижнем регистре, соединённые подчёркиваниями. Стандарт для идентификаторов в Python, Rust и Ruby и для имён колонок в SQL.
kebab-case
Слова в нижнем регистре, соединённые дефисами. Принято использовать для URL-slug, классов CSS и атрибутов HTML.
CONSTANT_CASE
Слова в верхнем регистре, соединённые подчёркиваниями. Применяется для констант и переменных окружения в большинстве языков.
Slugify
Нормализует строку для использования в URL-slug: убирает диакритику, удаляет пунктуацию и спецсимволы, переводит всё в нижний регистр и соединяет слова дефисами.
Операции с текстом
Извлечь e-mail
Сканирует ввод и извлекает все найденные адреса e-mail без дубликатов, по одному на строку. Удобно вытаскивать адреса из вставленных писем или HTML-дампов.
Извлечь URL
Достаёт все http(s)-ссылки из ввода без дубликатов, по одной на строку. Полезно собирать ссылки из скопированных статей или логов чата.
Нумерация строк
Добавляет к каждой строке её номер (с 1), выровненный так, чтобы двоеточия совпадали вертикально. Быстрый способ ссылаться на строки при шаринге сниппета.
Перемешать строки
Случайно перемешивает порядок всех строк по алгоритму Фишера–Йетса. Подходит для плейлистов, списков имён или выборочных данных.
Случайная строка
Выбирает одну случайную непустую строку из ввода. Идеально для выбора имени, победителя или подсказки из списка.
Объединить строки
Сжимает многострочный текст в одну строку, разделённую пробелами, со сжатыми лишними пробелами. Помогает разворачивать абзацы, разорванные жёсткими переводами строк из писем или PDF.
В LF
Нормализует окончания строк Windows (CRLF) и старого Mac (CR) к Unix-стилю LF. Часто нужно перед пушем в репозиторий или прогоном через Unix-утилиты.
В CRLF
Преобразует окончания строк к Windows-стилю CRLF. Полезно при создании файлов, открываемых в Блокноте, или для инструментов, требующих CRLF.
Кодирование и хеширование
Base64 кодировать
Кодирует UTF-8 текст в строку Base64. Удобно для безопасного хранения данных в JSON, встраивания небольших ассетов в HTML или передачи коротких payload-ов в URL.
Base64 декодировать
Декодирует строку Base64 обратно в UTF-8 текст. Возвращает пустую строку, если ввод не является корректным Base64.
URL кодировать
Процентно кодирует строку, чтобы её можно было безопасно использовать в query-строке или сегменте пути URL.
URL декодировать
Декодирует процентно кодированную URL-строку, возвращая исходные символы.
HTML экранировать
Заменяет пять зарезервированных символов HTML (<, >, &, ", ') на соответствующие сущности, чтобы безопасно вставлять недоверенный текст в HTML.
HTML раскодировать
Декодирует HTML-сущности (именованные и числовые) обратно в исходные символы.
Убрать HTML
Удаляет все HTML-теги из ввода и декодирует распространённые сущности, оставляя только обычный текст. Блочные элементы вроде p, br и li заменяются на переводы строк, чтобы сохранить структуру.
ROT13
Простой шифр замены, который заменяет каждую букву на отстоящую на 13 позиций далее в алфавите. ROT13 самообратен: применённый дважды, он восстанавливает исходный текст.
Текст → двоичный
Кодирует каждый UTF-8 байт ввода как 8-битное двоичное число, разделённое пробелами. Удобно для низкоуровневых демо и упражнений по информатике.
Двоичный → текст
Декодирует последовательность 8-битных двоичных чисел обратно в UTF-8 текст. Пробелы, запятые и прочие нецифровые символы игнорируются.
Текст → hex
Кодирует каждый UTF-8 байт ввода как двузначное шестнадцатеричное значение. Часто используется при отладке кодировок и для передачи бинарных данных в виде обычного текста.
Hex → текст
Декодирует последовательность побайтовых шестнадцатеричных значений обратно в UTF-8 текст. Пробелы и не-hex символы игнорируются.
Декоративный и стильный
Зачёркнутый текст
Добавляет после каждого символа комбинирующий знак Unicode (U+0336), благодаря которому текст выглядит зачёркнутым в обычном тексте, био соцсетей и большинстве чатов.
Подчёркнутый текст
Добавляет после каждого символа комбинирующий знак Unicode (U+0332), чтобы текст выглядел подчёркнутым без HTML и Markdown.
Текст вверх ногами
Сопоставляет каждому символу его визуально перевёрнутый Unicode-аналог и инвертирует порядок, чтобы результат выглядел как исходный текст, повёрнутый на 180°.
Зеркальный текст
Зеркалит каждый символ по горизонтали с помощью обратных Unicode-глифов и переворачивает порядок строки — как при чтении в зеркале.