Ein kurzer Leitfaden zur Groß- und Kleinschreibung
Groß- und Kleinschreibung ist die Art, wie Schriftsprachen zwischen größeren Großbuchstaben und kleineren Kleinbuchstaben unterscheiden. Schriftsysteme, die beide kennen, paaren sie: Jeder Großbuchstabe hat einen kleingeschriebenen Zwilling, der Namen, Laut und Platz im Alphabet teilt. Alles Weitere ist ein kurzer Streifzug durch die Umformungen, die dieses Tool leistet, und wann du zu welcher greifst.
Groß-/Kleinschreibung & Text
GROSSBUCHSTABEN
Jeder Buchstabe erscheint als Versalie. Gut für kurze Labels, Warnungen und Abkürzungen; vermeide sie in längeren Passagen — sie lesen sich langsamer und wirken schnell wie Geschrei.
kleinbuchstaben
Jeder Buchstabe wird in seiner kleinen Form dargestellt. Kleinbuchstaben sind in modernen Texten der Standard für Fließtext — gut lesbar und ruhig im Schriftbild.
Satzform
Nur der erste Buchstabe jedes Satzes wird großgeschrieben — dazu Eigennamen und alles, was die Grammatik verlangt. Die natürliche Wahl für Absätze, UI-Texte und einen Konversationston.
Titelform
Wichtige Wörter — Nomen, Verben, Adjektive — werden großgeschrieben, kurze Artikel, Präpositionen und Konjunktionen bleiben klein. Der klassische Überschriftenstil in Magazinen und Blogs.
Großgeschrieben
Der erste Buchstabe jedes Wortes ist groß, alle anderen sind klein — anders als bei der Titelform ohne Ausnahme für kurze Wörter. Üblich für Namen, Marken und kurze Labels, die einheitlich wirken sollen.
aBwEcHsElNd
Beginnt klein und wechselt mit jedem weiteren Zeichen die Schreibweise, unabhängig von der ursprünglichen Groß- und Kleinschreibung. Wird vor allem für stilistische Betonung in sozialen Medien verwendet.
gROSS/kLEIN tAUSCHEN
Dreht jeden Buchstaben um: Großbuchstaben werden klein und kleine werden groß. Praktisch für schnelle visuelle Effekte oder um ungewöhnliche Schreibweisen in einem Ausgangstext zu prüfen.
Umkehren
Kehrt die Reihenfolge aller Zeichen im Text um. Nützlich für schnelles Verschleiern, Palindrom-Checks oder verspielte Typografie.
Leerzeichen säubern
Fasst mehrere Leerzeichen zu einem zusammen, entfernt führenden und abschließenden Leerraum aus jeder Zeile und löscht leere Zeilen. Ideal, um aus Word oder einer PDF kopierten Text aufzuräumen.
Duplikate entfernen
Entfernt doppelte Zeilen und behält jeweils nur das erste Auftreten. Die Reihenfolge der übrigen Zeilen bleibt erhalten.
Zeilen sortieren
Sortiert alle Zeilen alphabetisch mit einem sprachsensitiven Vergleich. Praktisch, um Listen, CSV-Spalten oder JSON-Schlüsselmengen zu ordnen.
Markdown entfernen
Entfernt Markdown-Syntax — Überschriften, Hervorhebungen, Code-Blöcke, Links, Bilder, Listen — und gibt reinen Text zurück.
Entwickler
camelCase
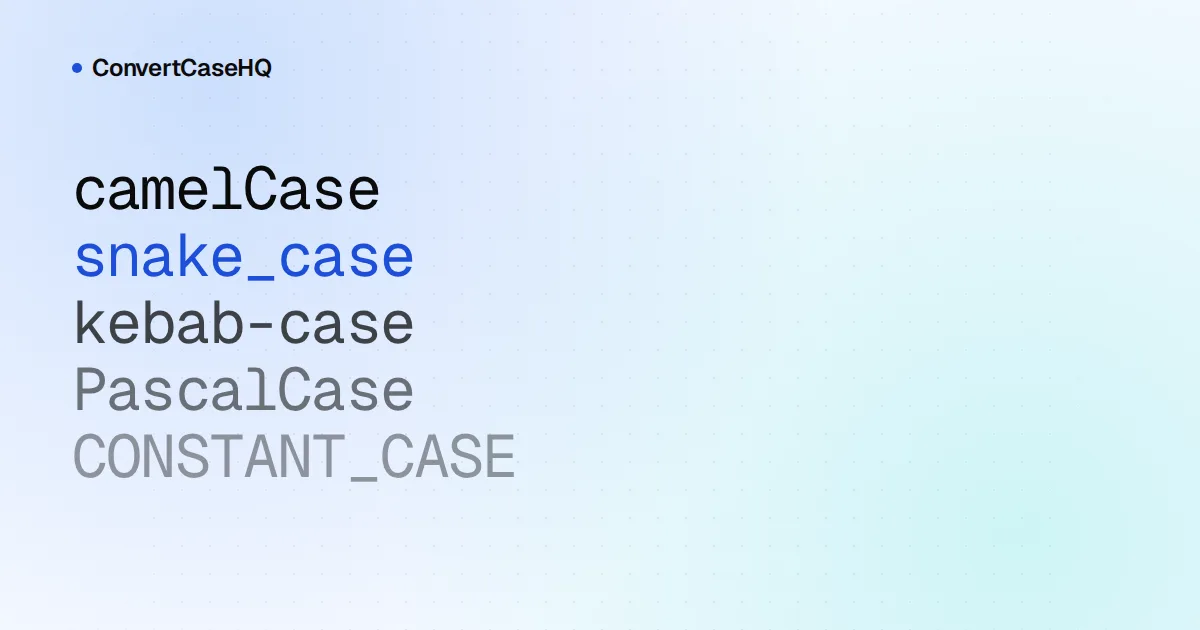
Das erste Wort wird kleingeschrieben, jedes weitere mit einem Großbuchstaben begonnen und alle ohne Leerzeichen verbunden. Der Standardstil für Variablen und Funktionen in JavaScript, Java und Swift.
PascalCase
Jedes Wort — einschließlich des ersten — beginnt mit einem Großbuchstaben und wird ohne Leerzeichen verbunden. Üblich für Typnamen: Klassen, Interfaces und React-Komponenten.
snake_case
Kleingeschriebene Wörter, verbunden mit Unterstrichen. Der Standard für Bezeichner in Python, Rust und Ruby sowie für die meisten SQL-Spaltennamen.
kebab-case
Kleingeschriebene Wörter, verbunden mit Bindestrichen. Die Konvention für URL-Slugs, CSS-Klassennamen und HTML-Attribute.
CONSTANT_CASE
Großgeschriebene Wörter, verbunden mit Unterstrichen. In den meisten Programmiersprachen für echte Konstanten und für Umgebungsvariablen gebräuchlich.
Slugify
Normalisiert einen Text für die Verwendung als URL-Slug: entfernt Akzente, streicht Satzzeichen und Sonderzeichen, schreibt alles klein und verbindet die Wörter mit Bindestrichen.
Textoperationen
E-Mails extrahieren
Durchsucht die Eingabe und extrahiert jede gefundene E-Mail-Adresse, dedupliziert und eine pro Zeile. Praktisch, um Adressen aus eingefügten E-Mail-Threads oder HTML-Dumps zu ziehen.
URLs extrahieren
Holt jede http(s)-URL aus der Eingabe, dedupliziert und eine pro Zeile. Nützlich, um Links aus kopierten Artikeln oder Chat-Logs zu sammeln.
Zeilennummern
Stellt jeder Zeile ihre 1-basierte Zeilennummer voran, gepolstert, sodass die Doppelpunkte vertikal ausgerichtet sind. Schneller Weg, Zeilen beim Teilen eines Snippets zu referenzieren.
Zeilen mischen
Mischt die Reihenfolge aller Zeilen mit Fisher–Yates. Nützlich für Playlists, Namenslisten oder Beispieldaten.
Zufällige Zeile
Wählt eine zufällige nicht leere Zeile aus der Eingabe. Praktisch, um einen Namen, einen Gewinner oder einen Prompt aus einer Liste zu ziehen.
Zeilen verbinden
Fasst mehrzeiligen Text in einer Zeile zusammen, durch Leerzeichen getrennt, mit komprimierten Whitespaces. Hilfreich, um harte Zeilenumbrüche aus E-Mails oder PDFs zu entfernen.
In LF umwandeln
Normalisiert Windows- (CRLF) und alte Mac-Zeilenenden (CR) auf Unix-Stil LF. Oft nötig, bevor Dateien in Repositories landen oder durch Unix-Tools laufen.
In CRLF umwandeln
Konvertiert Zeilenenden in den Windows-Stil CRLF. Nützlich für Dateien, die in Notepad geöffnet oder von CRLF-erwartenden Tools genutzt werden.
Kodierung & Hashing
Base64 kodieren
Kodiert beliebigen UTF-8-Text in eine Base64-Zeichenfolge. Nützlich, um binärsichere Daten in JSON zu speichern, kleine Assets in HTML einzubetten oder kurze Nutzlasten in URLs zu teilen.
Base64 dekodieren
Dekodiert eine Base64-Zeichenfolge zurück in UTF-8-Text. Liefert eine leere Zeichenfolge, falls die Eingabe kein gültiges Base64 ist.
URL kodieren
Prozentkodiert eine Zeichenfolge, damit sie sicher in einem URL-Querystring oder Pfadsegment verwendet werden kann.
URL dekodieren
Dekodiert eine prozentkodierte URL-Zeichenfolge zurück in ihre Originalzeichen.
HTML escapen
Ersetzt die fünf reservierten HTML-Zeichen (<, >, &, ", ') durch ihre Entitäten, damit nicht vertrauenswürdiger Text sicher in HTML eingebettet werden kann.
HTML entschärfen
Dekodiert HTML-Entities (benannte und numerische) zurück in ihre Originalzeichen.
HTML entfernen
Entfernt alle HTML-Tags aus der Eingabe und dekodiert gängige Entities, sodass nur reiner Text übrig bleibt. Block-Elemente wie p, br und li werden zu Zeilenumbrüchen, um die Struktur zu erhalten.
ROT13
Einfache Substitutionschiffre, bei der jeder Buchstabe durch den 13 Positionen weiter im Alphabet stehenden ersetzt wird. ROT13 ist selbstinvers: zweimal anwenden ergibt den Originaltext.
Text zu Binär
Kodiert jedes UTF-8-Byte der Eingabe als 8-Bit-Binärzahl, durch Leerzeichen getrennt. Nützlich für Demos und Informatikübungen auf niedriger Ebene.
Binär zu Text
Dekodiert eine Folge von 8-Bit-Binärzahlen zurück in UTF-8-Text. Leerzeichen, Kommas und andere Nicht-Binärzeichen werden ignoriert.
Text zu Hex
Kodiert jedes UTF-8-Byte der Eingabe als zweistelligen Hexadezimalwert. Üblich beim Debuggen von Kodierungen und beim Teilen binärer Daten als reiner Text.
Hex zu Text
Dekodiert eine Folge hexadezimaler Bytewerte zurück in UTF-8-Text. Leerzeichen und Nicht-Hex-Zeichen werden ignoriert.
Schmuck & Dekoration
Durchgestrichener Text
Fügt nach jedem Zeichen ein Unicode-Kombinationszeichen (U+0336) ein, sodass der Text in reinem Text, Social-Media-Bios und den meisten Chats durchgestrichen erscheint.
Unterstrichener Text
Fügt nach jedem Zeichen ein Unicode-Kombinationszeichen (U+0332) ein, sodass der Text ganz ohne HTML oder Markdown unterstrichen aussieht.
Auf den Kopf gestellter Text
Bildet jedes Zeichen auf seine optisch invertierte Unicode-Form ab und kehrt die Reihenfolge um — der Text liest sich, als wäre er um 180° gedreht.
Spiegeltext
Spiegelt jedes Zeichen mit umgekehrten Unicode-Glyphen und dreht die Zeichenfolge — wie Text in einem Spiegel.