字母大小写快速指南
字母大小写是书面语言区分较大的大写字母与较小的小写字母的方式。同时具备两者的书写系统将它们成对出现:每个大写字母都有一个对应的小写字母,共享相同的名称、发音以及在字母表中的位置。下面简要介绍本工具支持的各种转换,以及何时该使用它们。
大小写与文本
大写
把每个字母以大写形式显示。适合简短的标签、警示和缩写;超过几个单词就尽量避免 —— 读起来更慢,容易给人喊叫的感觉。
小写
把每个字母以小写形式显示。它是现代写作正文的默认形式 —— 易于扫读,在页面上低调安静。
句首大写
只把每句话的第一个字母大写,加上专有名词以及英文语法要求大写的地方。最适合段落、界面文案和对话化的写作。
标题大写
把名词、动词、形容词等主要词大写,冠词、介词和连词保持小写。出版物和博客文章标题的经典样式。
首字母大写
每个单词的首字母大写,其余字母小写 —— 与标题大写不同,所有词都不例外。常用于姓名、品牌和需要统一外观的短标签。
大小写交替
无视原大小写,从小写开始逐字符切换。常见于社交媒体上做风格化的强调。
大小写反转
把每个字母的大小写颠倒过来。可用于快速的视觉效果,或检查源字符串中不寻常的大小写模式。
反转
反转文本中所有字符的顺序。可用于快速混淆、回文检查或趣味排版。
清理空白
把连续空白合并为一个,删除每行首尾的空白,并去掉空行。非常适合清理从 Word 或 PDF 粘贴来的文本。
去除重复行
删除重复的行,只保留每行第一次出现的位置。其余行的顺序保持不变。
行排序
对每一行使用与区域设置相关的比较进行字母顺序排序。适合整理列表、CSV 列或 JSON 键集合。
去除 Markdown
去除 Markdown 语法 — 标题、强调、代码块、链接、图片、列表 — 并返回纯文本。
开发者
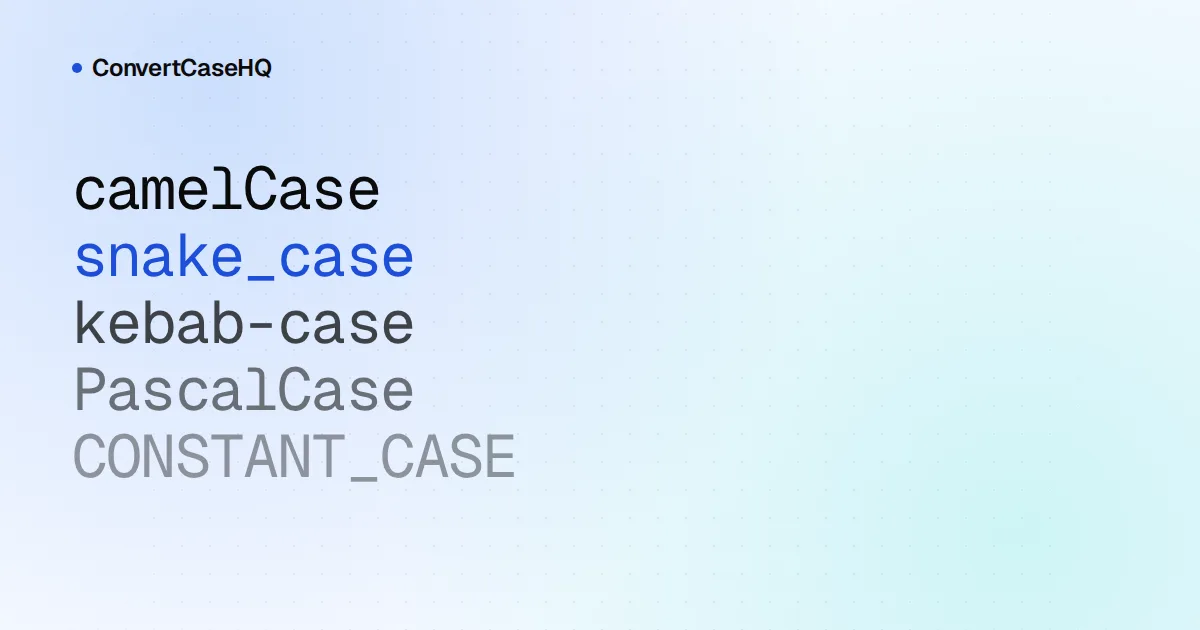
camelCase
开发者风格:第一个单词小写,后续单词首字母大写,全部连接。JavaScript、Java、Swift 中变量和函数的默认约定。
PascalCase
每个单词(包括第一个)都首字母大写,并不加分隔符地连接。常用于类型名:类、接口和 React 组件。
snake_case
小写单词用下划线连接。是 Python、Rust 和 Ruby 标识符以及 SQL 列名的标准。
kebab-case
小写单词用连字符连接。URL slug、CSS 类名以及 HTML 属性的常见约定。
CONSTANT_CASE
大写单词用下划线连接。多数语言中常量和环境变量的写法。
Slug 化
将字符串规范化为 URL slug:去除变音符号、剔除标点和特殊字符、全部转换为小写,并用连字符连接剩余的单词。
文本操作
提取邮箱
扫描输入并提取找到的所有邮箱地址,去重后每行一个。可用于从粘贴的邮件线程或 HTML 转储中提取地址。
提取 URL
从输入中拉取每个 http(s) URL,去重后每行一个。适合从复制的文章或聊天记录中收集链接。
添加行号
为每行添加从 1 开始的行号,对齐填充以使冒号纵向对齐。便于在分享代码片段时引用行号。
随机打乱行
使用 Fisher–Yates 算法随机化所有行的顺序。适合打乱播放列表、姓名列表或样本数据。
随机一行
从输入中随机挑选一条非空行。适合从列表中选取名称、获奖者或提示语。
合并为一行
将多行文本合并为一行,使用空格分隔,并压缩多余空白。可还原邮件或 PDF 中被强制换行的段落。
转为 LF
将 Windows (CRLF) 和旧 Mac (CR) 行尾标准化为 Unix 风格 LF。在推送到仓库或交给 Unix 工具前常需此操作。
转为 CRLF
将行尾转换为 Windows 风格 CRLF。生成需在记事本打开或被要求 CRLF 的工具使用的文件时很有用。
编码与哈希
Base64 编码
将任意 UTF-8 文本编码为 Base64 字符串。便于在 JSON 中存放二进制安全数据、在 HTML 中嵌入小型资源,或通过 URL 分享短小负载。
Base64 解码
将 Base64 字符串解码回 UTF-8 文本。如果输入不是有效的 Base64,会返回空字符串。
URL 编码
对字符串进行百分号编码,以便安全用于 URL 的查询字符串或路径段。
URL 解码
解码经过百分号编码的 URL 字符串,还原为原始字符。
HTML 转义
将 HTML 五个保留字符(<、>、&、"、')替换为对应实体,以便将不可信的文本安全地嵌入 HTML。
HTML 反转义
将 HTML 实体(命名和数字)解码回对应的原始字符。
去除 HTML
删除输入中所有 HTML 标签并解码常见实体,仅保留纯文本。p、br、li 等块级元素会转换为换行,以保留结构。
ROT13
简单的替换密码,将每个字母替换为字母表中位置加 13 的字母。ROT13 是自反的:再应用一次即可还原。
文本转二进制
把输入的每个 UTF-8 字节编码为以空格分隔的 8 位二进制数。常用于底层演示和计算机科学练习。
二进制转文本
把 8 位二进制数序列解码回 UTF-8 文本。空白、逗号及其他非二进制字符都会被忽略。
文本转十六进制
把输入的每个 UTF-8 字节编码为两位十六进制值。常用于调试编码或以纯文本分享二进制数据。
十六进制转文本
把按字节的十六进制数序列解码回 UTF-8 文本。空白和非十六进制字符会被忽略。
花式与装饰
删除线文本
在每个字符后插入 Unicode 组合标记(U+0336),使文本在纯文本、社交简介和大多数聊天工具中显示为划掉的样式。
下划线文本
在每个字符后插入 Unicode 组合标记(U+0332),让文本在不使用 HTML 或 Markdown 的情况下也呈现下划线。
上下颠倒文本
把每个字符映射为视觉上相反的 Unicode 字形,并反转顺序,让结果看起来像把原文旋转了 180 度。
镜像文本
使用反向 Unicode 字形把每个字符水平翻转,并把字符串顺序倒过来 — 就像在镜子里读到的一样。